Pesquisa da USP ensina inteligência artificial a entender a estrutura das frases em português
Projeto coordenado pelo ICMC cria uma grande base de textos analisados por pesquisadores para treinar sistemas capazes de identificar como as palavras se relacionam em uma frase.
Quando uma pessoa lê a frase “O menino encontrou o livro”, consegue identificar rapidamente quem realizou a ação, o que foi encontrado e qual é a relação entre as palavras. Para uma inteligência artificial, porém, chegar a esse tipo de compreensão exige uma grande quantidade de exemplos e informações organizadas.
É esse o trabalho realizado por pesquisadores do Instituto de Ciências Matemáticas e de Computação (ICMC) da USP, em São Carlos, dentro do projeto Synestech.AI. Coordenada pelo professor Thiago Pardo, a pesquisa desenvolve recursos para ensinar sistemas de inteligência artificial a analisar textos em português, identificando não apenas se uma palavra é um verbo, substantivo ou pronome, mas também qual papel ela desempenha na frase e como se relaciona com as demais.
Para fazer isso, a equipe utiliza o Universal Dependencies (UD), um padrão internacional que funciona como uma espécie de linguagem comum para descrever a estrutura das frases em diferentes idiomas.
O objetivo é construir ferramentas que permitam à inteligência artificial lidar melhor com a língua portuguesa falada e escrita no Brasil.
Como ensinar uma máquina a entender uma frase
Na escola, aprendemos que uma frase pode ter sujeito, verbo, objeto, predicado e outras funções gramaticais. Para uma máquina, essas relações precisam ser transformadas em dados que possam ser reconhecidos pelos computadores.
É aí que entra o trabalho dos pesquisadores. Eles analisam textos palavra por palavra e registram tanto a classe gramatical de cada termo quanto sua relação com as outras palavras da frase.
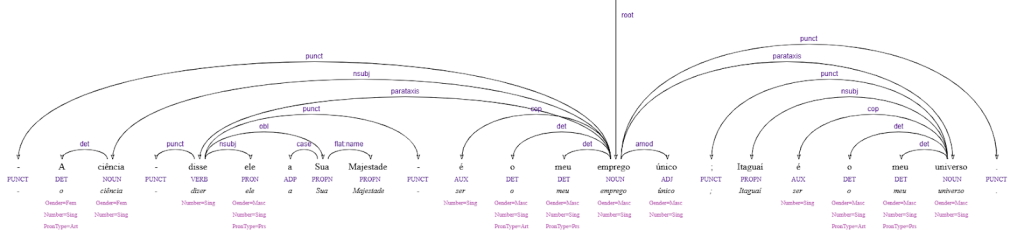
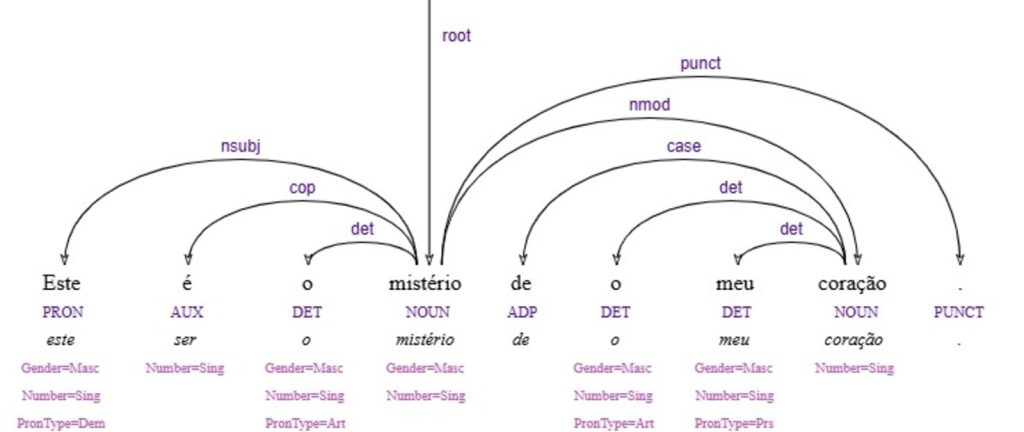
Em uma frase como “O homem que morreu”, por exemplo, o artigo “o” está relacionado à palavra “homem”. Já “morreu” está ligado a “homem”, enquanto “que” estabelece uma relação com o verbo. Essas conexões formam uma espécie de mapa da frase.
O Universal Dependencies organiza essas informações seguindo critérios comuns a diferentes línguas. Isso permite comparar estruturas do português com as de outros idiomas e também facilita o aproveitamento de recursos desenvolvidos em diferentes países.
“Você tem uma dependência: o ‘o’ depende de ‘homem’, e ‘que morreu’ é uma oração adjetiva que está qualificando ‘homem’. Então, ‘morreu’ é dependente de ‘homem’. Já o ‘que’, pronome que se refere a ‘homem’, é dependente sujeito de ‘morreu’”, explica a pós-doutoranda Magali Duran, do ICMC.
Primeiro, pessoas analisam. Depois, a máquina aprende
Esse processo não é feito simplesmente apertando um botão. Antes que a inteligência artificial consiga reconhecer padrões sozinha, pesquisadores precisam produzir exemplos confiáveis.
Os textos são analisados por pessoas, geralmente em duplas, que comparam suas interpretações. Quanto maior a concordância entre elas, mais consistente é a base de dados utilizada posteriormente para treinar os sistemas.
Hoje, a equipe utiliza também uma estratégia que acelera o trabalho. O próprio sistema faz uma primeira análise dos textos e os pesquisadores revisam e corrigem os erros.
“Ele faz uma análise, nós olhamos aquilo e corrigimos os erros. O que é muito difícil também, porque às vezes são tantos arcos, tantas coisas para olhar, que achar os erros é como procurar agulha no palheiro”, conta Magali.
A diversidade dos textos é importante porque a língua portuguesa não funciona sempre da mesma maneira. Por isso, a equipe trabalha com diferentes tipos de material, incluindo textos jornalísticos, jurídicos e literários, além de registros de fala.
Entre as obras analisadas estão O Pequeno Príncipe, de Antoine de Saint-Exupéry, e O Alienista, de Machado de Assis. A escolha também considera a possibilidade de disponibilizar os textos para novos estudos, especialmente quando as obras estão em domínio público.
O sistema que aprende com esses exemplos
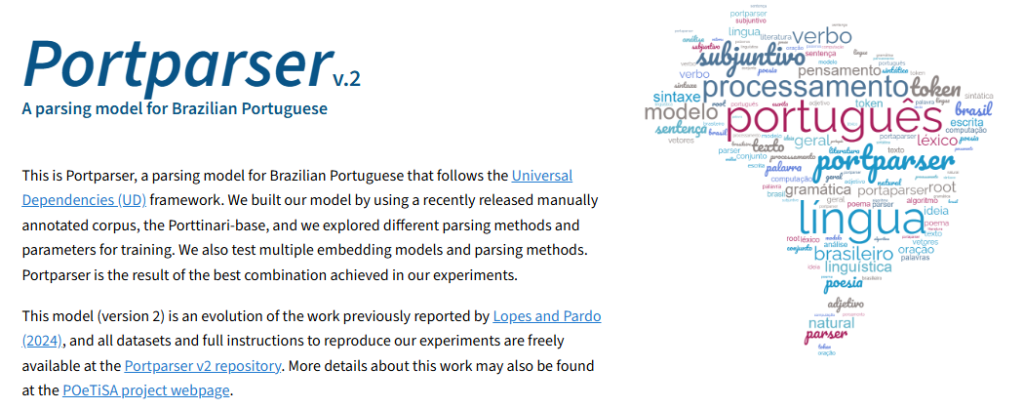
Os dados produzidos pelos pesquisadores servem de exemplo para o desenvolvimento do Portparser, sistema criado para analisar automaticamente a estrutura de textos em português.
Desenvolvido pela pós-doutoranda Lucelene Lopes, também integrante do projeto, o Portparser recebe uma frase e tenta identificar as relações entre suas palavras, atribuindo funções como sujeito e objeto.
É como se os pesquisadores ensinassem ao computador, por meio de milhares de exemplos, a reconhecer a estrutura de uma frase. Depois de treinado, o sistema consegue receber um texto novo e fazer uma análise por conta própria.
Para isso, os modelos de inteligência artificial procuram identificar padrões nos exemplos produzidos pelos pesquisadores. Também são utilizados recursos que reúnem informações sobre as palavras e suas variações gramaticais, como gênero e número.
“Quando fornecemos um texto novo para o sistema, o sistema usa tudo isso e tenta recriar a estrutura sintática, o melhor que ele pode”, explica Thiago Pardo.
Atualmente, o Portparser chega a quase 97% de acerto em suas análises. Os casos em que o sistema erra, porém, mostram justamente uma das maiores dificuldades do trabalho: a própria complexidade da língua.
O desafio de uma língua que muda de contexto para contexto
Uma mesma ideia pode ser expressa de muitas maneiras. Além disso, algumas frases permitem mais de uma interpretação, dependendo do contexto.
“A língua é um grande desafio. Tem muitos jeitos de falar a mesma coisa e a maioria dos casos em que o sistema computacional erra, um humano não tem certeza de como resolver. São casos em que você tem ambiguidade, subjetividade”, explica Pardo.
Essa diversidade também faz com que o trabalho de construção das bases de dados revele situações que nem sempre estão previstas nas classificações existentes.
Para Magali Duran, analisar textos reais é uma maneira de encontrar novas formas de uso da língua. “Quando você começa a fazer uma anotação e a entrar em contato com textos reais, é quase como se você fosse para uma floresta e olhasse todas as espécies lá e, de repente, você visse uma espécie que não estava catalogada”, compara.
Na prática, isso significa que os pesquisadores podem encontrar uma construção inesperada ou um fenômeno linguístico que exige uma nova interpretação. “Esse é o desafio e é também a parte divertida da coisa”, afirma.
Duas áreas da inteligência artificial
O Synestech.AI reúne pesquisadores do ICMC e do Instituto de Matemática, Estatística e Ciência da Computação (IME) da USP, em São Paulo. No ICMC, a pesquisa se concentra no Processamento de Linguagem Natural, área que busca fazer com que computadores trabalhem com textos e linguagem humana. No IME, os pesquisadores atuam principalmente com visão computacional, voltada para o processamento e a interpretação de imagens.
A união das duas áreas permite desenvolver aplicações capazes de trabalhar com diferentes tipos de informação.
“No ICMC, trabalhamos com Processamento de Linguagem Natural. No IME, a equipe atua com visão computacional e processamento de imagens. O projeto reuniu essas duas frentes porque há interesse em desenvolver aplicações capazes de lidar tanto com imagens quanto com textos. Algumas pesquisas seguem caminhos próprios de cada área; outras combinam as duas”, explica Thiago Pardo.
O projeto começou em 2020, com financiamento da FAPESP e da IBM, e passou a contar, em 2026, com aporte da Motorola. Cerca de 80 pesquisadores participam da frente de Processamento de Linguagem Natural no ICMC, entre professores, estudantes de graduação e pós-graduação, pós-doutorandos e colaboradores externos. Somando a equipe do IME, são aproximadamente 100 pesquisadores.
As atividades estão previstas para continuar, ao menos, até o início de 2028.
Um recurso brasileiro para o português
Além de melhorar o desempenho de ferramentas de inteligência artificial, a pesquisa busca criar recursos próprios para o estudo computacional do português brasileiro.
Para Magali Duran, a continuidade do projeto permite que o conhecimento acumulado pelos pesquisadores não seja interrompido ao final de cada mestrado, doutorado ou pós-doutorado. Segundo ela, o trabalho já permitiu avanços importantes na qualidade das ferramentas desenvolvidas.
A construção de sistemas voltados especificamente para o português brasileiro também tem uma dimensão estratégica. Quanto mais recursos uma língua possui no campo da inteligência artificial, maior é a possibilidade de desenvolver tecnologias capazes de lidar adequadamente com suas características.
“Desenvolver um parser traz alguma representação para a língua portuguesa frente às outras línguas. É um diferencial competitivo para a ciência brasileira. Quando os nossos colegas usam o nosso sistema, eles estão usando um recurso feito e publicado aqui no Brasil por equipes brasileiras que estudaram profundamente a língua”, afirma Thiago Pardo.
No fundo, a pesquisa parte de uma questão que parece simples, mas está entre os grandes desafios da inteligência artificial: como transformar aquilo que uma pessoa entende naturalmente ao ler uma frase em informações que uma máquina consiga aprender?
O trabalho do Synestech.AI mostra que, antes de uma inteligência artificial interpretar a linguagem, é preciso compreender a própria língua em toda a sua diversidade.